Две метки, один SRH и очень вредная rp_filter: как Linux-сеть доехала от IP до SRv6 L3VPN
Спойлер: дело не в том, чтобы дописать в конфиг побольше слов
mpls,segment-routingиsrv6. Дело в том, чтобы после каждого такого слова выяснить — пакет-то куда поехал?
У нас есть десяток Linux-машин, соединённых виртуальными линками, и доступ по management-сети. На старте это не «MPLS-стенд»: IPv4 data-plane ещё отсутствует, FRR местами не установлен, а между соседями живут только интерфейсы и некоторое взаимное недоверие.
Цель была довольно амбициозная: пройти путь от голых P2P-линков до изолированных L3VPN, затем сделать steering через SR-MPLS и, наконец, довести один сервис до реально работающего SRv6 L3VPN. Не нарисовать идеальную схему задним числом, а последовательно строить слои и проверять, что в них происходит.
Это история именно такого эксперимента. Тут будут команды и кусочки FIB, но не будет простыни конфигов. Конфиг, который не подтвердился состоянием протокола или пакетом на проводе, в этой истории не считается достижением.
Что за зверинец был в начале
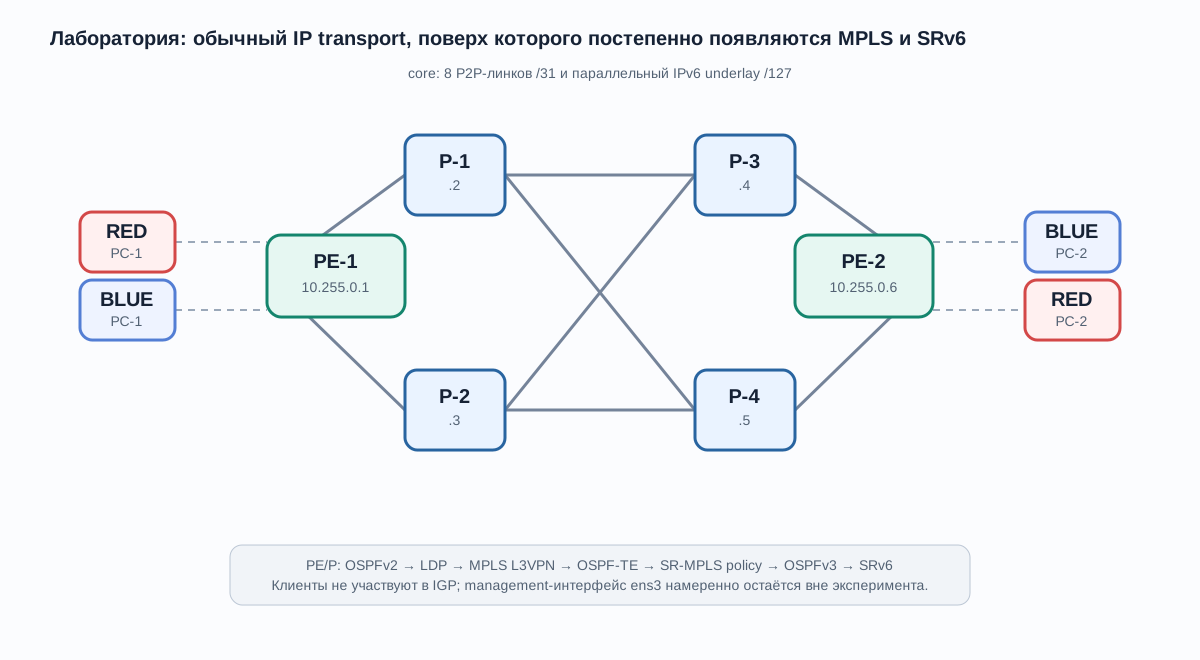
Core состоит из двух PE и четырёх P-узлов. Между PE есть две ромбовидные дороги через P-1/P-3 и P-2/P-4, плюс два cross-link. На каждом краю живут по два клиента: RED и BLUE. Management ens3 существует отдельно; его мы сознательно не трогали. Потерять SSH ради красивого netplan apply — такой себе educational content.
На data-линки выдали адреса из 10.10.0.0/27, каждому P2P-стыку по /31:
| Линк | Адреса |
|---|---|
| PE-1 — P-1 | 10.10.0.0/31 — 10.10.0.1/31 |
| PE-1 — P-2 | 10.10.0.2/31 — 10.10.0.3/31 |
| P-1 — P-3 | 10.10.0.4/31 — 10.10.0.5/31 |
| P-1 — P-4 | 10.10.0.6/31 — 10.10.0.7/31 |
| P-2 — P-3 | 10.10.0.8/31 — 10.10.0.9/31 |
| P-2 — P-4 | 10.10.0.10/31 — 10.10.0.11/31 |
| P-3 — PE-2 | 10.10.0.12/31 — 10.10.0.13/31 |
| P-4 — PE-2 | 10.10.0.14/31 — 10.10.0.15/31 |
Четыре клиентских стыка получили оставшиеся /31. На P и PE включили net.ipv4.ip_forward=1; на PC не включали — они здесь клиенты, а не маршрутизаторы, которым просто пока не дали достаточно власти.
Перед тем как идти дальше, проверили каждый линк двумя способами: ip route get должен выбирать ожидаемый интерфейс, а два ICMP echo должны получить два ответа. Например:
# PE-1 → P-1
10.10.0.1 dev ens4 src 10.10.0.0
2 packets transmitted, 2 received, 0% packet loss

# P-2 → P-3
10.10.0.9 dev ens6 src 10.10.0.8
2 packets transmitted, 2 received, 0% packet loss
На этом месте дальние адреса не ходили — и это было нормально. У каждого были лишь connected-маршруты. Очень полезный момент: отсутствие маршрута между PE до IGP — не баг, который надо замазать MPLS. Это честная граница первого слоя.
Сначала научим IP вообще ездить
Для OSPFv2 назначили устойчивые loopback/router-id:
| Узел | Loopback | Node SID позже |
|---|---|---|
| PE-1 | 10.255.0.1/32 |
16001 |
| P-1 | 10.255.0.2/32 |
16002 |
| P-2 | 10.255.0.3/32 |
16003 |
| P-3 | 10.255.0.4/32 |
16004 |
| P-4 | 10.255.0.5/32 |
16005 |
| PE-2 | 10.255.0.6/32 |
16006 |
Loopback поднимает systemd unit до запуска FRR — router-id не должен внезапно зависеть от того, что сейчас думает физический порт. На PE и P поставили FRR 8.4.4 с ospfd, включили все core-интерфейсы в area 0 как point-to-point и задали passive-interface default. Клиентские порты и loopback не должны слать OSPF Hello в пустоту.
Ожидалось 16 направленных соседств: два у каждого PE и три у каждого P. Именно столько Full/- и получили. А на PE-1 маршрут до loopback PE-2 приехал двумя равными путями:
O>* 10.255.0.6/32 [110/3] via 10.10.0.1, ens4
  *                       via 10.10.0.3, ens5
Теперь нужен был не только красивый show ip route, но и kernel FIB. Он действительно выбрал один из ECMP next hop, а ping loopback-to-loopback вернулся без потерь:
$ ip route get 10.255.0.6 from 10.255.0.1
10.255.0.6 from 10.255.0.1 via 10.10.0.3 dev ens5

$ ping -I 10.255.0.1 -c 4 10.255.0.6
4 packets transmitted, 4 received, 0% packet loss
TTL в ответе был 62. То есть между PE действительно побывали два транзитных P. Вот теперь у последующих протоколов появилась нормальная транспортная основа.
Добавляем MPLS, но пока не сервис
LDP нужен не потому, что «MPLS надо включить». У нас уже есть IP-доставка до loopback, поэтому можно завести второй forwarding-механизм: ingress добавляет label для FEC, а транзитный P решает, что сделать с верхней меткой.
На шести P/PE загрузили mpls_router, включили MPLS input только на core-интерфейсах, задали net.mpls.platform_labels=1048575 и запустили ldpd. На трёх машинах модуль отсутствовал в текущем наборе пакетов: доставили подходящий к ядру linux-modules-extra, без reboot. На access-портах MPLS не включали — клиентам совершенно незачем принимать label packets.
Первая попытка была поучительной. LDP-блок добавили прямо в /etc/frr/frr.conf; daemon запустился, но show mpls ldp ipv4 interface не показала ни одного interface. То есть конфиг написан, а работающий LDP state не появился. Попробовали применить секции через vtysh с явными выходами из вложенных режимов и сохранили write memory. После этого порты стали ACTIVE, а соседи — OPERATIONAL.
В качестве FEC взяли loopback PE-2. На PE-1 LDP выдал local label 23 и получил remote label 22 от обоих next hop:
show mpls ldp ipv4 binding 10.255.0.6/32
ipv4 10.255.0.6/32 10.255.0.2  Local 23  Remote 22  in use yes
ipv4 10.255.0.6/32 10.255.0.3  Local 23  Remote 22  in use yes

ip route get 10.255.0.6 from 10.255.0.1
10.255.0.6 from 10.255.0.1 encap mpls 22 via 10.10.0.3 dev ens5
На P-2 входящая 22 менялась на 25, а на входе его ens4 во время ICMP был пойман самый убедительный из возможных аргументов:
ethertype MPLS unicast (0x8847)
  MPLS (label 22, tc 0, [S], ttl 64)
  10.255.0.1 > 10.255.0.6: ICMP echo request
Иными словами, LDP распространил метки, ядро их установило, PE реально сделал push, P реально принял MPLS. Праздновать можно, но осторожно: это пока MPLS transport. Клиентского сервиса здесь ещё нет.
Две VPN, две метки и один core, которому всё равно
Следующей задачей были два изолированных сервиса:
| VPN | Сеть слева | Сеть справа | RT |
|---|---|---|---|
| RED | 10.10.0.16/31 |
10.10.0.22/31 |
65000:100 |
| BLUE | 10.10.0.18/31 |
10.10.0.20/31 |
65000:200 |
На обоих PE подняли Linux VRF: RED с table 1001 и BLUE с table 1002. Access-интерфейсы перенесли в нужные VRF; netplan для PE оставили только с core-адресами, а VRF и CE-адреса поднимает идемпотентный systemd unit до FRR. Иначе netplan после перезагрузки честно вернёт CE-адрес в default VRF и всё станет очень познавательно, но не в хорошем смысле.
MP-BGP между loopback PE в AS 65000 переносит VPNv4 и extended communities. RD у каждого PE уникальны, RT общий для цвета. Это существенно: RD делает NLRI уникальным, а именно RT решает, в какую VRF можно импортировать маршрут.
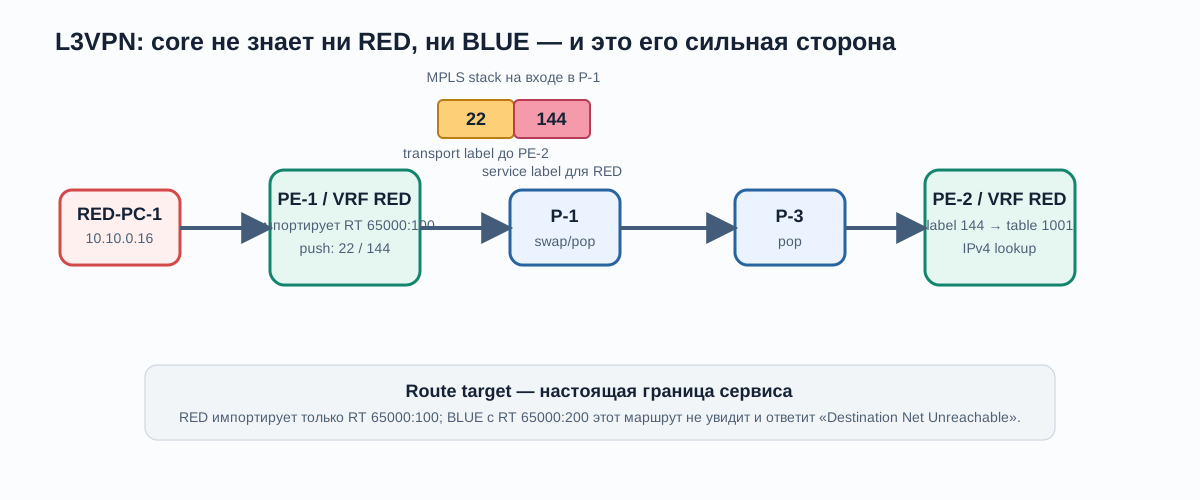
После export/import kernel FIB PE-1 показал то, ради чего всё затевалось:
ip route get 10.10.0.22 vrf RED
10.10.0.22 encap mpls 22/144 via 10.10.0.1 dev ens4 table 1001

ip route get 10.10.0.20 vrf BLUE
10.10.0.20 encap mpls 22/145 via 10.10.0.3 dev ens5 table 1002
Верхняя label доставляет до egress PE; нижняя определяет сервис на egress. В RED ping между PC прошёл, а capture на P-1 увидел стек 22/144 с IPv4 внутри. BLUE сделал то же самое со своей service label. И что не менее важно, RED→BLUE и BLUE→RED получили Destination Net Unreachable от локального PE: чужой RT не импортирован, а не «потерялся где-то в core».
Здесь случилась и маленькая история про порядок восстановления. После включения BGP FRR на PE перезапустился; OSPF быстро вернулся в Full, но один LDP neighbor PE-2 остался в SYN-SENT. Discovery был, IP ping между transport address был, а журнал сказал: LDP стартовал до того, как OSPF вернул маршрут, и получил Network is unreachable. clear mpls ldp neighbor после готового IP-пути поднял соседство. VPN тут была ни при чём. Если нижний слой ещё собирает себя по кусочкам, чинить BGP-конфигом бессмысленно.
Traffic Engineering: данные — ещё не путь
Когда обычный OSPF видит равные дороги, он раздаёт их ECMP. Он не знает, что мы хотим пустить важный сервис через P-1/P-3, что на альтернативной дороге мало свободного ресурса, либо что часть сети на обслуживании.
В OSPF добавили TE-information plane: mpls-te on, router address, export и link parameters. Учебная модель была явной, не попыткой выдать bandwidth виртуального интерфейса за достоверную телеметрию:
| Коридор | TE metric | Unreserved BW | Роль в модели |
|---|---|---|---|
| PE-1 — P-1 — P-3 — PE-2 | 10 | 100 MB/s | preferred / gold |
| PE-1 — P-2 — P-4 — PE-2 | 20 | 25 MB/s | мало свободного ресурса |
| Cross-link P-1—P-4, P-2—P-3 | 50 | 50 MB/s | резерв |
Сначала link parameters были видны локально, а TE-LSA в LSDB не было. show ip ospf показал ключевую строчку: OpaqueCapability flag is disabled. После включения opaque capability на всех P/PE PE-1 увидел 16 area-local opaque LSA — по одному направлению каждого core-линка. Например:
Opaque-Type 1 (Traffic Engineering LSA)
Advertising Router: 10.255.0.2
Traffic Engineering Metric: 10
Maximum Reservable Bandwidth: 1e+08 (Bytes/sec)
Unreserved Bandwidth [0..7]: 1e+08 (Bytes/sec)
Ещё FRR отказался принять max-bw меньше уже известного interface maximum. И тут он прав: maximum не может быть меньше других bandwidth-полей. Оставили actual maximum FRR, а учебную доступность выразили max-rsv-bw и unrsv-bw.
После всего этого обычный маршрут до PE-2 остался ECMP, LDP и L3VPN не сломались. Так и должно быть. TED — это данные для CSPF/контроллера, не заклинание, которое само перенаправляет ICMP. На FRR 8.4.4 нет rsvpd и полноценного RSVP-TE control plane с CSPF, reservation и TE-LSP; объявить данный этап «рабочим RSVP-TE» было бы неправдой. Зато TE-LSA на самом деле разошлись, и это доказанный фундамент для следующего шага.
Когда transport label становится segment
Segment Routing решает другую часть TE-задачи: ingress кладёт в stack инструкции, а transit исполняет общий SID, не храня per-policy state каждого LSP. В нашем SRGB 16000–23999 Node SID совпадают с таблицей loopback выше. Например, [16002 | 16004 | 16006] — поехать к P-1, затем к P-3, затем к PE-2.
На всех P/PE включили OSPF SR-MPLS с Node MSD 8. В FIB PE-1 это стало совсем не абстракцией:
ip -f mpls route show 16006
16006 proto ospf
  nexthop as to 16006 via inet 10.10.0.1 dev ens4
  nexthop as to 16006 via inet 10.10.0.3 dev ens5

ip route get 10.255.0.6 from 10.255.0.1
10.255.0.6 encap mpls 16006 via 10.10.0.3 dev ens5
На P-2 capture поймал MPLS label 16006 с тем же ICMP внутри. Для L3VPN изменился лишь верхний transport label: 16006/144 для RED и 16006/145 для BLUE. Service label, а значит VRF-изоляция, никуда не исчезли. LDP neighbors оставили включёнными специально: механизмы сосуществуют, но в FIB для этих FEC теперь предпочитается SR.
Классический RSVP-TE и SR-MPLS не надо объявлять хорошим и плохим. RSVP даёт signalling и reservation, если это настроено; SR несёт путь в segment list и проще масштабирует policy на транзите. SR сам не измеряет congestion и не создаёт резервированную полосу. В обоих случаях нужен разумный источник topology/constraints.
SR Policy: вот теперь путь действительно выбран
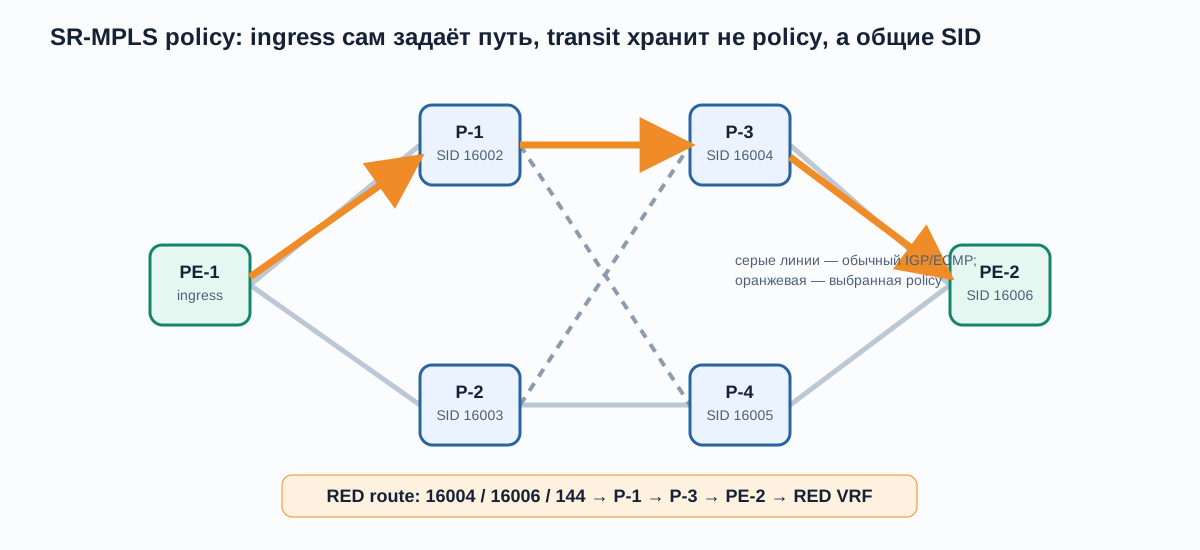
Один Node SID PE-2 всё ещё разрешает ECMP: пакет может уйти через P-1 или P-2. Поэтому на PE-1 включили pathd и создали локальную explicit SR policy. Без внешнего PCE, без имитации магического контроллера — один проверяемый segment list:
16002 → 16004 → 16006
 P-1     P-3     PE-2
Policy получила color 100, endpoint 10.255.0.6 и binding SID 24000. pathd выбрал candidate path, Zebra установила его в dataplane. При этом BSID развернулся сразу в 16004/16006 через P-1: первый segment уже совпадает с соседним next hop, это оптимизация, а не внезапная пропажа P-1.
Чтобы policy стала не музейным экспонатом, inbound BGP route-map на VPNv4 routes от PE-2 выставил им sr-te color 100. В маленькой лабе это касается обоих импортируемых сервисов. В нормальной сети такой steering надо сузить по RT/community/prefix — «всё к PE-2» редко оказывается хорошим продуктовым требованием.
FIB RED на PE-1 изменился с:
10.10.0.22 encap mpls 16006/144 ...
на:
10.10.0.22 encap mpls 16004/16006/144 via 10.10.0.1 dev ens4 table 1001
Capture на входе P-1 увидел ровно этот stack. LFIB P-1 для 16004 отправлял остаток к P-3, а LFIB P-3 для 16006 — к PE-2. Наконец можно говорить «явный путь»: это не предположение по конфигу, а список меток и обработка на каждом нужном transit.
SRv6: тот же замысел, другой data plane
SR-MPLS в этой лабе работал. SRv6 не добавляли потому, что MPLS «устарел». SRv6 интересен, если transport уже IPv6 и хочется выражать путь и сетевую функцию IPv6 SID. За это приходится платить IPv6+SRH overhead, MTU-планированием и более сложной операционной моделью.
Сначала появился параллельный IPv6 underlay: на восьми core-линках /127 из fd10:10:0:x::/127, OSPFv3 и locator prefixes. Перед SRH проверили обычный IPv6 route и ping до locator PE-2. И только после этого начали говорить про SRv6 — иначе debugging превратился бы в кашу из OSPFv3, IPv6 и seg6 одновременно.
Для ручного эксперимента использовали:
| Узел | SID | Behavior |
|---|---|---|
| P-1 | fd10:6:0:2:1::/128 |
End |
| P-3 | fd10:6:0:4:1::/128 |
End |
| PE-2 | fd10:6:0:6:100::/128 |
End.DT4 vrftable 1001 |
На ingress RED VRF получил IPv4 route с encap seg6, на egress locator ловится policy rule в table 200, где лежит seg6local End.DT4. seg6_enabled=1 включили только на data-интерфейсах: Linux по умолчанию SRH принимать не обязан.
На P-1 и затем на PE-2 реально поймали IPv6+SRH с внутренним IPv4 echo request. Значит, OSPFv3, locator reachability и SRv6 encap были исправны. Но RED-PC-2 ответ не получил. Восьмой этап можно было бы назвать «SRv6 L3VPN готов» и сделать вид, что всё остальное — погода. Но пакет не дошёл в access VRF, значит не готов.
«Kernel не умеет» оказался слишком удобной версией
Сначала на PE-2 прогнали официальный Linux selftest srv6_end_dt4_l3vpn_test.sh в одноразовых namespace. Он прошёл 18 из 18. Kernel умеет End.DT4; искать надо в разнице между selftest и живым стендом.
Ключ оказался в reverse-path filtering. После End.DT4 inner IPv4 packet имеет source 10.10.0.16, но оказывается из core context. Его обратный маршрут лежит в RED VRF, а не global IPv4 table. При rp_filter=2 lookup не видел VRF-route и выбрасывал пакет до access-интерфейса:
ip route get 10.10.0.16 from 10.10.0.14 iif ens5
RTNETLINK answers: Network is unreachable
Upstream selftest перед созданием VRF RPF выключает. На стенде сделали ровно настолько широкое изменение, насколько требовалось: rp_filter=0 для RED, core- и RED access-интерфейсов, а management ens3 оставили с rp_filter=2. Это не «выключайте RPF везде»; это конкретная особенность service/VRF dataplane, которую в production надо проектировать вместе с policy routing и проверкой источника.
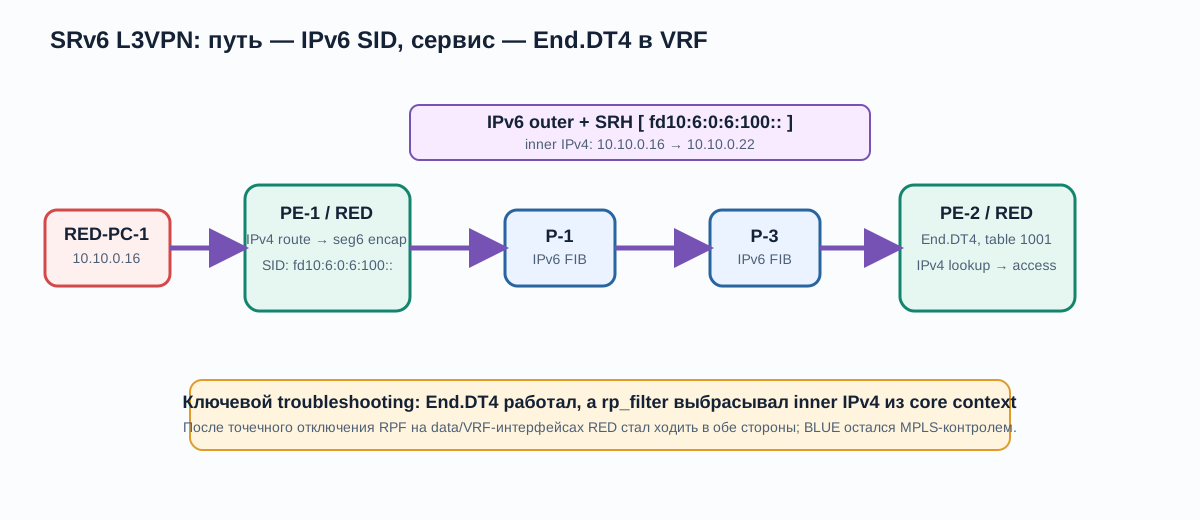
После этого на PE-1 и PE-2 сохранили lab-srv6-red.service: он после network, VRF и FRR идемпотентно возвращает RPF settings, locator rule, egress End.DT4, IPv6 route до peer SID и IPv4 SRv6 Encap route. Результат после перезапуска сервисов:
PE-1, RED table 1001
10.10.0.22/31 encap seg6 mode encap segs [fd10:6:0:6:100::] dev ens4

PE-2, RED table 1001
10.10.0.16/31 encap seg6 mode encap segs [fd10:6:0:11:100::] dev ens4

RED-PC-1 → RED-PC-2: 3/3 replies, 0% loss
RED-PC-2 → RED-PC-1: 3/3 replies, 0% loss
В оба направления core увидел SRH и нужный inner IPv4. BLUE намеренно не мигрировали: он остался контрольным MPLS L3VPN с encap mpls 16004/16006/81 и продолжил успешно пинговаться. Это особенно приятный результат: в одной топологии можно руками увидеть два рабочих способа довезти один и тот же тип сервиса.
Что в итоге действительно построено
Получилась не «конфигурация из девяти глав», а несколько доказанных слоёв:
- На всех P2P-линках есть IPv4, соседние адреса доступны, forwarding включён только на тех узлах, где он нужен.
- OSPFv2 доставляет loopback между PE; маршрут подтверждён и FRR, и Linux FIB, и реальным ping.
- LDP распределяет метки, а packet capture показывает MPLS кадр в transit.
- RED и BLUE изолированы VRF/RT; MPLS L3VPN несёт transport плюс service label, а межсервисный трафик корректно не проходит.
- OSPF TE разносит TE-LSA, но честно не выдаётся за RSVP-TE на FRR без
rsvpd. - SR-MPLS Node SID работает в FIB, а SR policy реально задаёт RED путь P-1 → P-3 → PE-2.
- RED — рабочий static SRv6 L3VPN dataplane: SRH проходит core,
End.DT4выдаёт IPv4 в нужную VRF, путь работает в обе стороны.
Последняя оговорка важна: это пока не native BGP SRv6 L3VPN control plane. SID и service routes для RED восстанавливает локальный systemd script. Следующее разумное усложнение — advertisement и steering через поддерживаемый BGP SRv6 control plane. Оно имеет смысл именно потому, что dataplane уже доказан: теперь есть на что накладывать control plane, а не наоборот.
Что почитать, если хочется раскопать глубже
- RFC 8986: Segment Routing over IPv6 — модель SID и behaviors.
- Linux seg6 sysctl — почему SRH сам по себе Linux не принимает.
- Linux selftest для SRv6 End.DT4 L3VPN — минимальная reference-модель service dataplane.
- FRR OSPF documentation — OSPF-TE и экспериментальная часть SR-MPLS в использованной ветке.
- FRR pathd — SR Policy, candidate path и binding SID.
В следующем эпизоде можно добавить контроллер, PCEP или BGP SRv6 services. Но это уже будет не попытка заставить пакет ехать в принципе, а разговор про то, как задавать ему намерение. А это, как водится, отдельный способ сделать сеть интересной.